B200 / BF16 / MLPBlock / final implementation
SwiGLU MLP Drop-H 技术报告
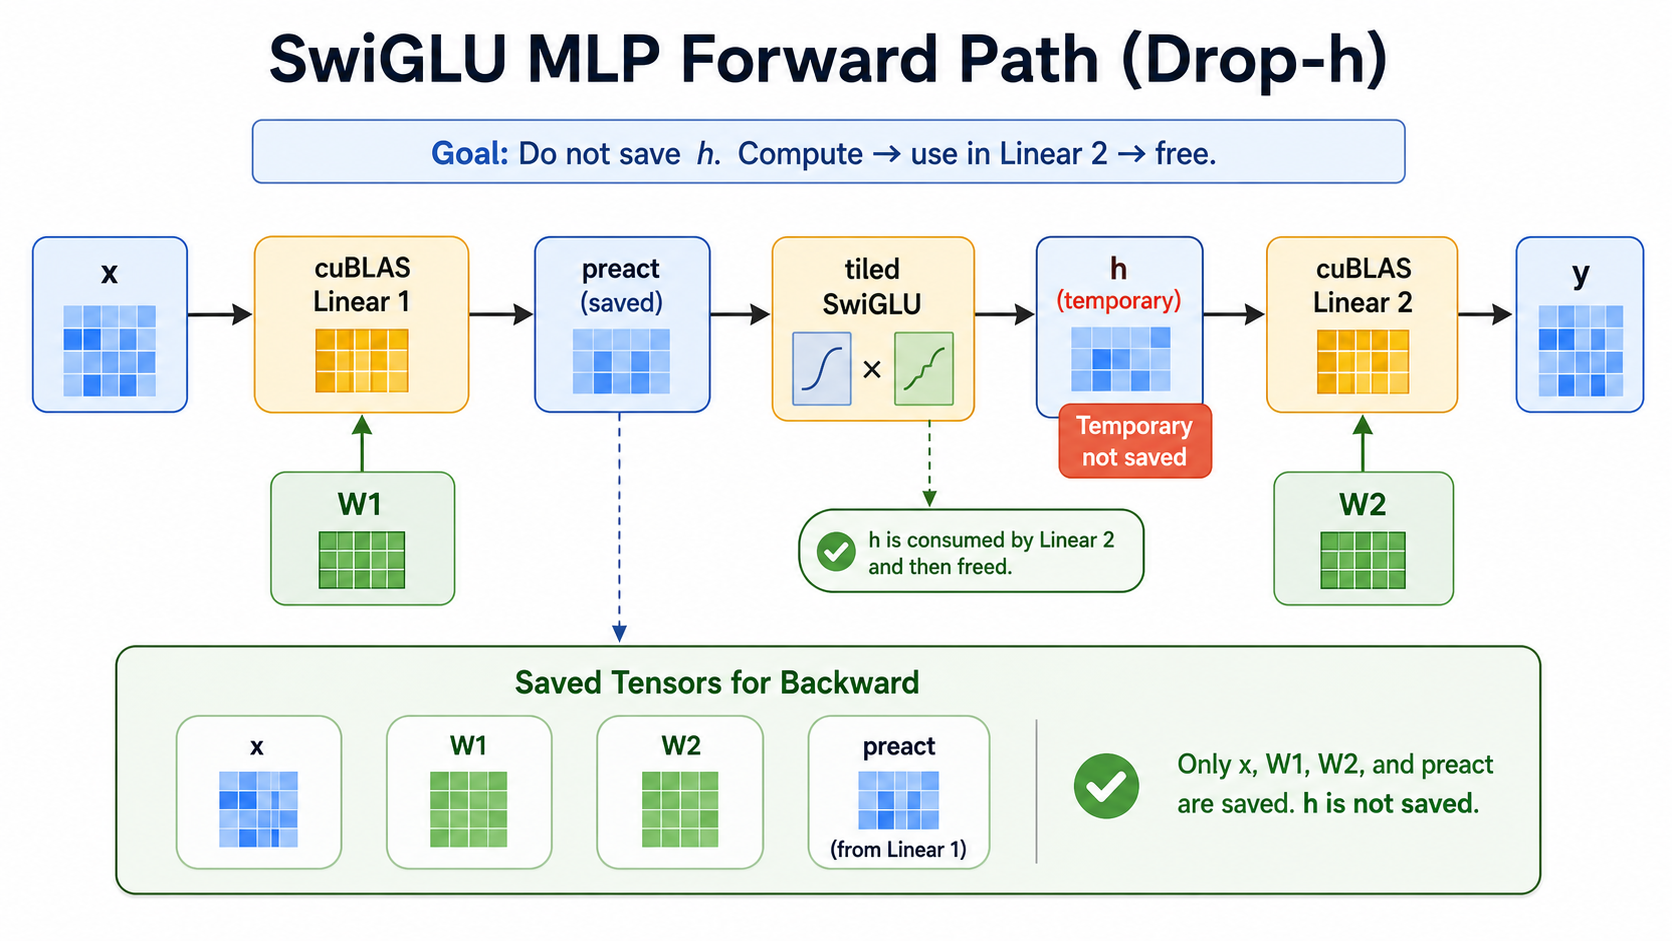
最终方案很朴素:大 GEMM 继续交给 cuBLAS;forward 保存 preact,不保存 hidden activation h;SwiGLU forward 使用 autotuned tiled Triton kernel;backward 用 non-inplace Triton kernel 同时重算 h 和生成 grad_preact,并允许 autotune 搜索 tile。target-shape paired A/B 重测后,速度和 baseline 按 tie 处理,forward activation 显存结论是确定收益。
keep cuBLAS GEMM
no weight pack
cuBLAS linear1/linear2
drop saved h
autotuned tiled SwiGLU forward
non-inplace autotuned bwd
bwd peak not targeted
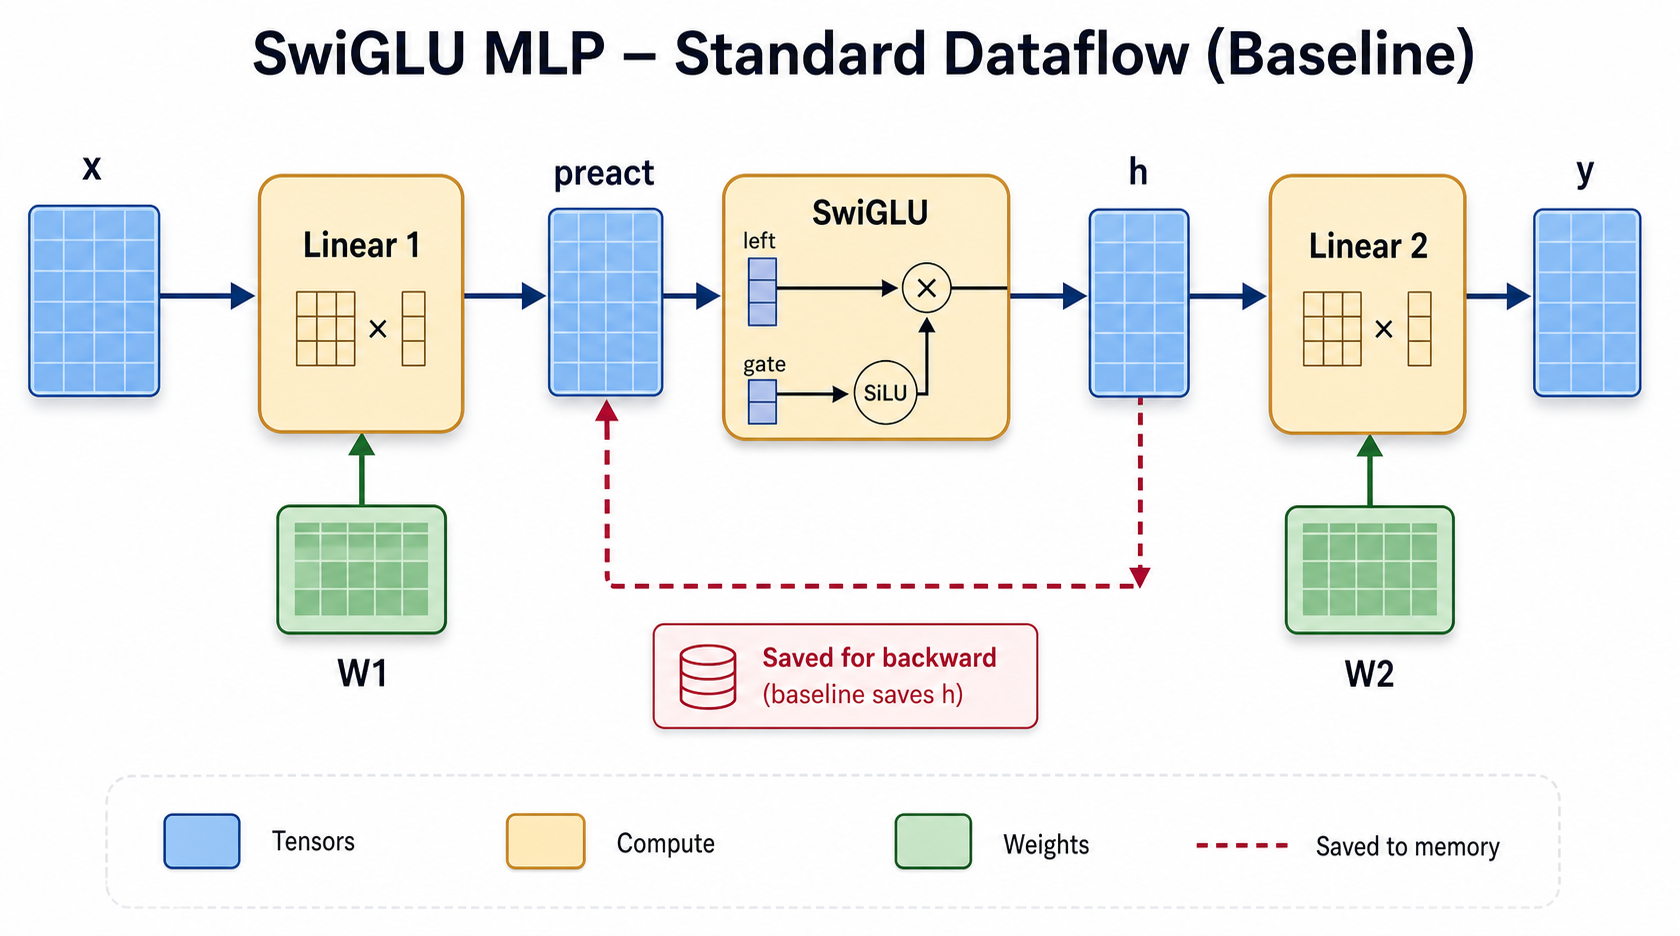
目标不是改变 SwiGLU 数学,而是改变 autograd 保存哪些中间量。普通路径在 forward 后保存 preact 和 h;最终路径只保存 preact,让 h 在 linear2 之后释放。backward 需要 h 时,从 preact 重算,并额外分配 h 和 grad_preact,这样 Triton autotune 的每个候选都看到同一份原始输入。
after-forward memory
686.1 MiB
baseline 990.6 MiB,节省 304.5 MiB
peak memory
1905.1 MiB
non-inplace backward 为速度让路;bwd peak 不作为目标
full fwd+bwd
tie
paired median delta -1.84%,低于 3% 判定阈值
correctness
exact
final drop_h 的 out / grad_x / grad_w1 / grad_w2 max relative error 都为 0.0
SwiGLU MLP 的原始数学
MLPBlock 可以拆成三段:第一层 linear 得到两倍 hidden 宽度的 preactivation,SwiGLU 把它压回 hidden,第二层 linear 回到输出维度。
Forward 公式
preact = x @ W1.T
left, gate = split(preact, dim=-1)
h = left * SiLU(gate)
y = h @ W2.T
Backward 公式
grad_h = grad_y @ W2

dleft = grad_h * SiLU(gate)
dgate = grad_h * left * SiLU'(gate)
grad_preact = concat(dleft, dgate)

grad_x  = grad_preact @ W1
grad_W1 = grad_preact.T @ x
grad_W2 = grad_y.T @ h
Forward:保存 preact,不保存 h
forward 仍然用 PyTorch/cuBLAS 做两个大 GEMM,避免自写 GEMM 损失吞吐。SwiGLU activation 默认走 autotuned tiled Triton kernel,BM/BN/num_warps 由 Triton autotune 选择。custom autograd 保存 x, W1, W2, preact,但不保存 h;h 仍然会临时写回 HBM,作为 linear2 的输入,用完即可释放。
实现骨架
def forward(ctx, x, w1, w2):
    x2 = x.reshape(-1, x.shape[-1])

    preact = F.linear(x2, w1)  # cuBLAS
    h = tiled_swiglu(preact)   # temporary; not saved
    y = F.linear(h, w2)        # cuBLAS

    ctx.save_for_backward(x2, w1, w2, preact)
    return y.reshape(*x.shape[:-1], y.shape[-1])
张量生命周期
| tensor | normal baseline | final drop_h |
|---|
x | saved | saved |
W1 | saved | saved |
W2 | saved | saved |
preact [M,2H] | saved | saved |
h [M,H] | saved | freed |
Backward:融合 h 重算和 grad_preact
backward 的关键路径是:先用 cuBLAS 算 grad_h = grad_y @ W2;然后 Triton kernel 一次性从 preact 和 grad_h 生成 h 与 grad_preact。最终版保持 non-inplace 语义:不覆盖 saved tensor,也不覆盖 grad_h,因此会额外分配 h 和 grad_preact。
Backward 实现骨架
def backward(ctx, grad_y):
    x, w1, w2, preact = ctx.saved_tensors
    grad_y = grad_y.reshape(-1, grad_y.shape[-1])

    grad_h = grad_y @ w2
    h, grad_preact = fused_h_and_grad_preact(
        preact,
        grad_h,
    )

    grad_w2 = grad_y.T @ h
    grad_x  = grad_preact @ w1
    grad_w1 = grad_preact.T @ x
    return grad_x, grad_w1, grad_w2
Fused kernel 伪代码
for tile in tiles(M, H):
    gh = load(grad_h)
    left = load(preact_left)
    gate = load(preact_gate)

    sig = sigmoid(gate)
    silu = gate * sig
    silu_prime = sig + silu * (1 - sig)

    h = bf16(left) * bf16(silu)
    dleft = gh * silu
    dgate = gh * left * silu_prime

    store(h_out, h)
    store(grad_preact_left, dleft)
    store(grad_preact_gate, dgate)
语义注意:当前最终版不原地覆盖 saved preact,也不原地覆盖 grad_h。这样代码语义更干净,也让 autotune 安全;代价是 backward peak memory 更高。
性能和显存对比
数据来自 B200 目标 shape [M,D,H,Dout] = [11136,3584,14336,3584]。重测使用同一张 B200、同一进程,A/B 随机交错运行,每个指标 40 个 paired samples。速度用 median 和 paired delta 判断;低于 3% 一律判为 tie。
最终判断:最终路径固定使用 non-inplace autotuned backward。它保留 forward 不保存 h 的显存收益,速度和 baseline 按 tie 处理;backward peak memory 会升高,但当前优化目标不再把 bwd peak 作为硬约束。
单个 MLP 目标 shape
| path |
correctness |
fwd ms |
bwd ms |
full ms |
paired verdict |
after-fwd MiB |
peak MiB |
| normal baseline |
reference |
2.2742 |
5.0725 |
7.4740 |
reference |
990.6 |
1698.6 |
| final drop_h + autotuned fwd/bwd |
exact |
2.2332 |
5.0033 |
7.3664 |
vs normal tie: fwd -2.02%, bwd -1.30%, full -1.84% |
686.1 |
1905.1 |
最终 paired A/B
| comparison |
paired delta |
结论 |
| final drop_h vs normal baseline |
fwd -2.02%, bwd -1.30%, full -1.84% |
低于 3% 阈值,端到端仍按 tie;peak memory 约 1905.1 MiB。 |
4-layer ParMLP stack memory
| path |
fwd ms |
bwd ms |
full ms |
after-fwd MiB |
peak MiB |
| normal baseline |
9.7416 |
21.4946 |
32.4014 |
3962.5 |
4670.5 |
| final drop_h |
9.7090 |
21.5666 |
32.0910 |
2744.5 |
3963.5 |
这张 stack 表用于看显存缩放,不作为速度胜负判据;速度胜负以单个 MLP paired A/B 表为准。
Exact 的口径:这里不是说数学上证明所有输入都 bitwise 恒等,而是 target-shape correctness 对比 baseline 时,final path 的 out、grad_x、grad_w1、grad_w2 最大相对误差都观测为 0.0。
取舍结论
这轮优化最后留下来的规律很清晰:大 GEMM 不要替换,小 activation/recompute kernel 可以自己写;省显存的核心是改变 saved tensor 生命周期,而不是把所有中间张量都消灭掉。
要保留
| 项目 | 原因 |
|---|
| cuBLAS GEMM | linear1、linear2、grad_x、grad_W1、grad_W2 都是主耗时,cuBLAS 吞吐最稳。 |
保存 preact | backward 精确需要 left/gate;不保存就要重算一次大 x @ W1.T。 |
不保存 h | 省掉 forward 后长期持有的 [M,H] activation,目标 shape 约 304.5 MiB。 |
| autotuned tiled SwiGLU forward | 现在作为唯一最终路径;BM/BN/num_warps 由 autotune 选择,forward 单项在 target shape 上约快 2.02%。 |
| fused activation backward | 一次 kernel 同时重算 h 并生成 grad_preact,减少 activation backward 的 kernel 数和中间调度开销。 |
| non-inplace autotuned backward | 现在作为唯一最终路径;不覆盖 saved tensor,允许 autotune 安全搜索 tile。 |
不要作为默认
| 项目 | 原因 |
|---|
| packed weight | 会改变参数 layout 和集成 contract;当前 no-pack 已经拿到主要显存收益。 |
| no-save 重算 linear1 | 省掉 preact 但多一次大 GEMM,backward 速度不划算。 |
| 替换大 GEMM 的 fusion | linear1/linear2 或 backward GEMM 一旦离开 cuBLAS,吞吐损失会吃掉 activation fusion 的收益。 |
最终推荐
生产默认
使用 final drop_h:forward 省掉 saved h,SwiGLU forward 走 autotuned tiled Triton,backward 走 non-inplace autotuned fused h + grad_preact。速度对 baseline 按 tie 处理,forward activation 显存是主要收益。
回退路径
fallback 走普通 MLPBlock:继续保存 h,速度和数值语义最保守,只是不拿 forward activation 显存收益。